Диаризация
Что такое диаризация и зачем она нужна при расшифровке звонков
Пятнадцатиминутный звонок в службу поддержки: клиент торопится, оператор уточняет детали, пару раз они перебивают друг друга. Вы прогоняете запись через speech-to-text и получаете аккуратный текст - но слитный, как стена: «Здравствуйте, подскажите, не пришёл заказ… да, сейчас посмотрю… назовите номер накладной». Где вопрос клиента, а где ответ оператора? Speech-to-text честно отвечает на вопрос «что сказали». На вопрос «кто сказал» отвечает другая технология - диаризация. Разберём, как она устроена, почему без неё не обходится анализ звонков и как включить её двумя строками кода.
Расшифровка есть, а «кто что сказал» - нет
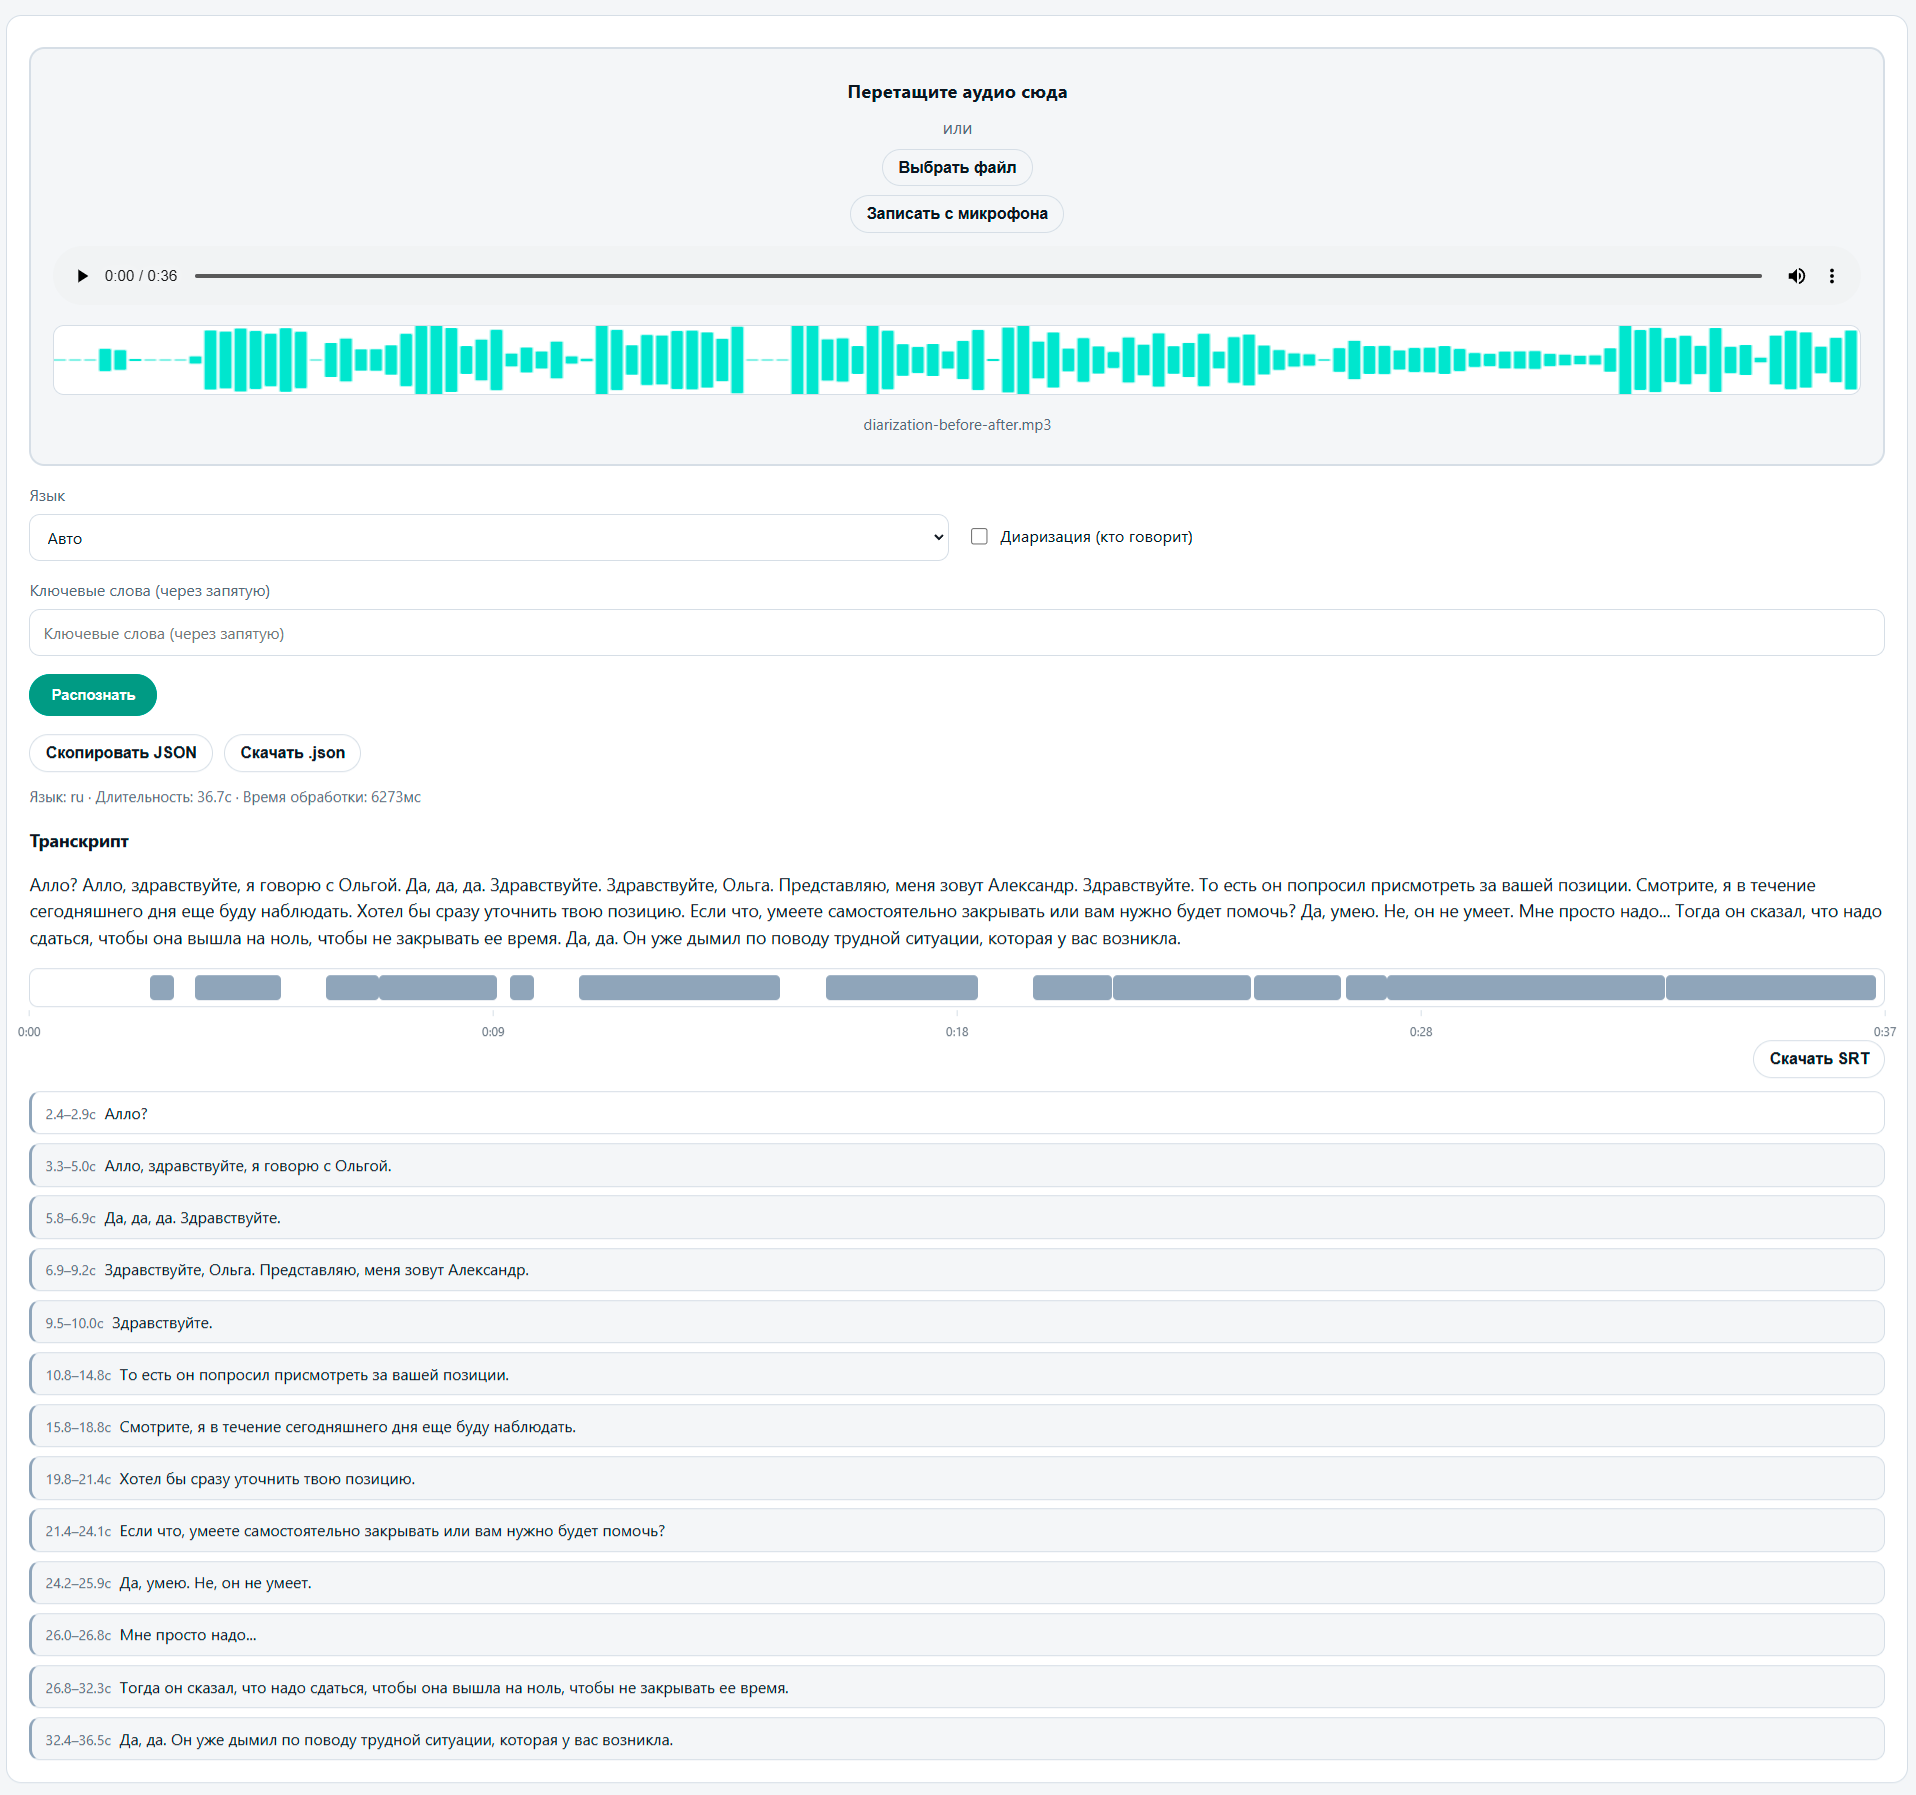
Начнём с неочевидной мысли: распознавание речи и диаризация - это две разные задачи, и решают их разные модели. STT слушает аудио и переводит звук в слова. Он не задумывается, что в записи может быть несколько голосов: для него весь файл - один непрерывный поток речи. Поэтому на выходе получается монолит: текст есть, структуры диалога нет.
На короткой записи это терпимо. На сорокаминутном разговоре менеджера с клиентом, где люди перебивают друг друга, вставляют «ага» и «угу» и договаривают фразы друг за другом, слитный текст превращается в ребус. Непонятно, кто задал вопрос и кто на него ответил, кто взял на себя обязательство, а кто отказался. А значит, нельзя ни оценить работу оператора, ни найти нужный момент, ни составить корректный протокол.
Поэтому диаризацию почти всегда включают там, где важна атрибуция - кому принадлежит реплика: контроль качества в колл-центрах, расшифровка интервью и подкастов, протоколы совещаний, судебные и медицинские записи. Везде, где текст без автора - это половина смысла.
Что такое диаризация простыми словами
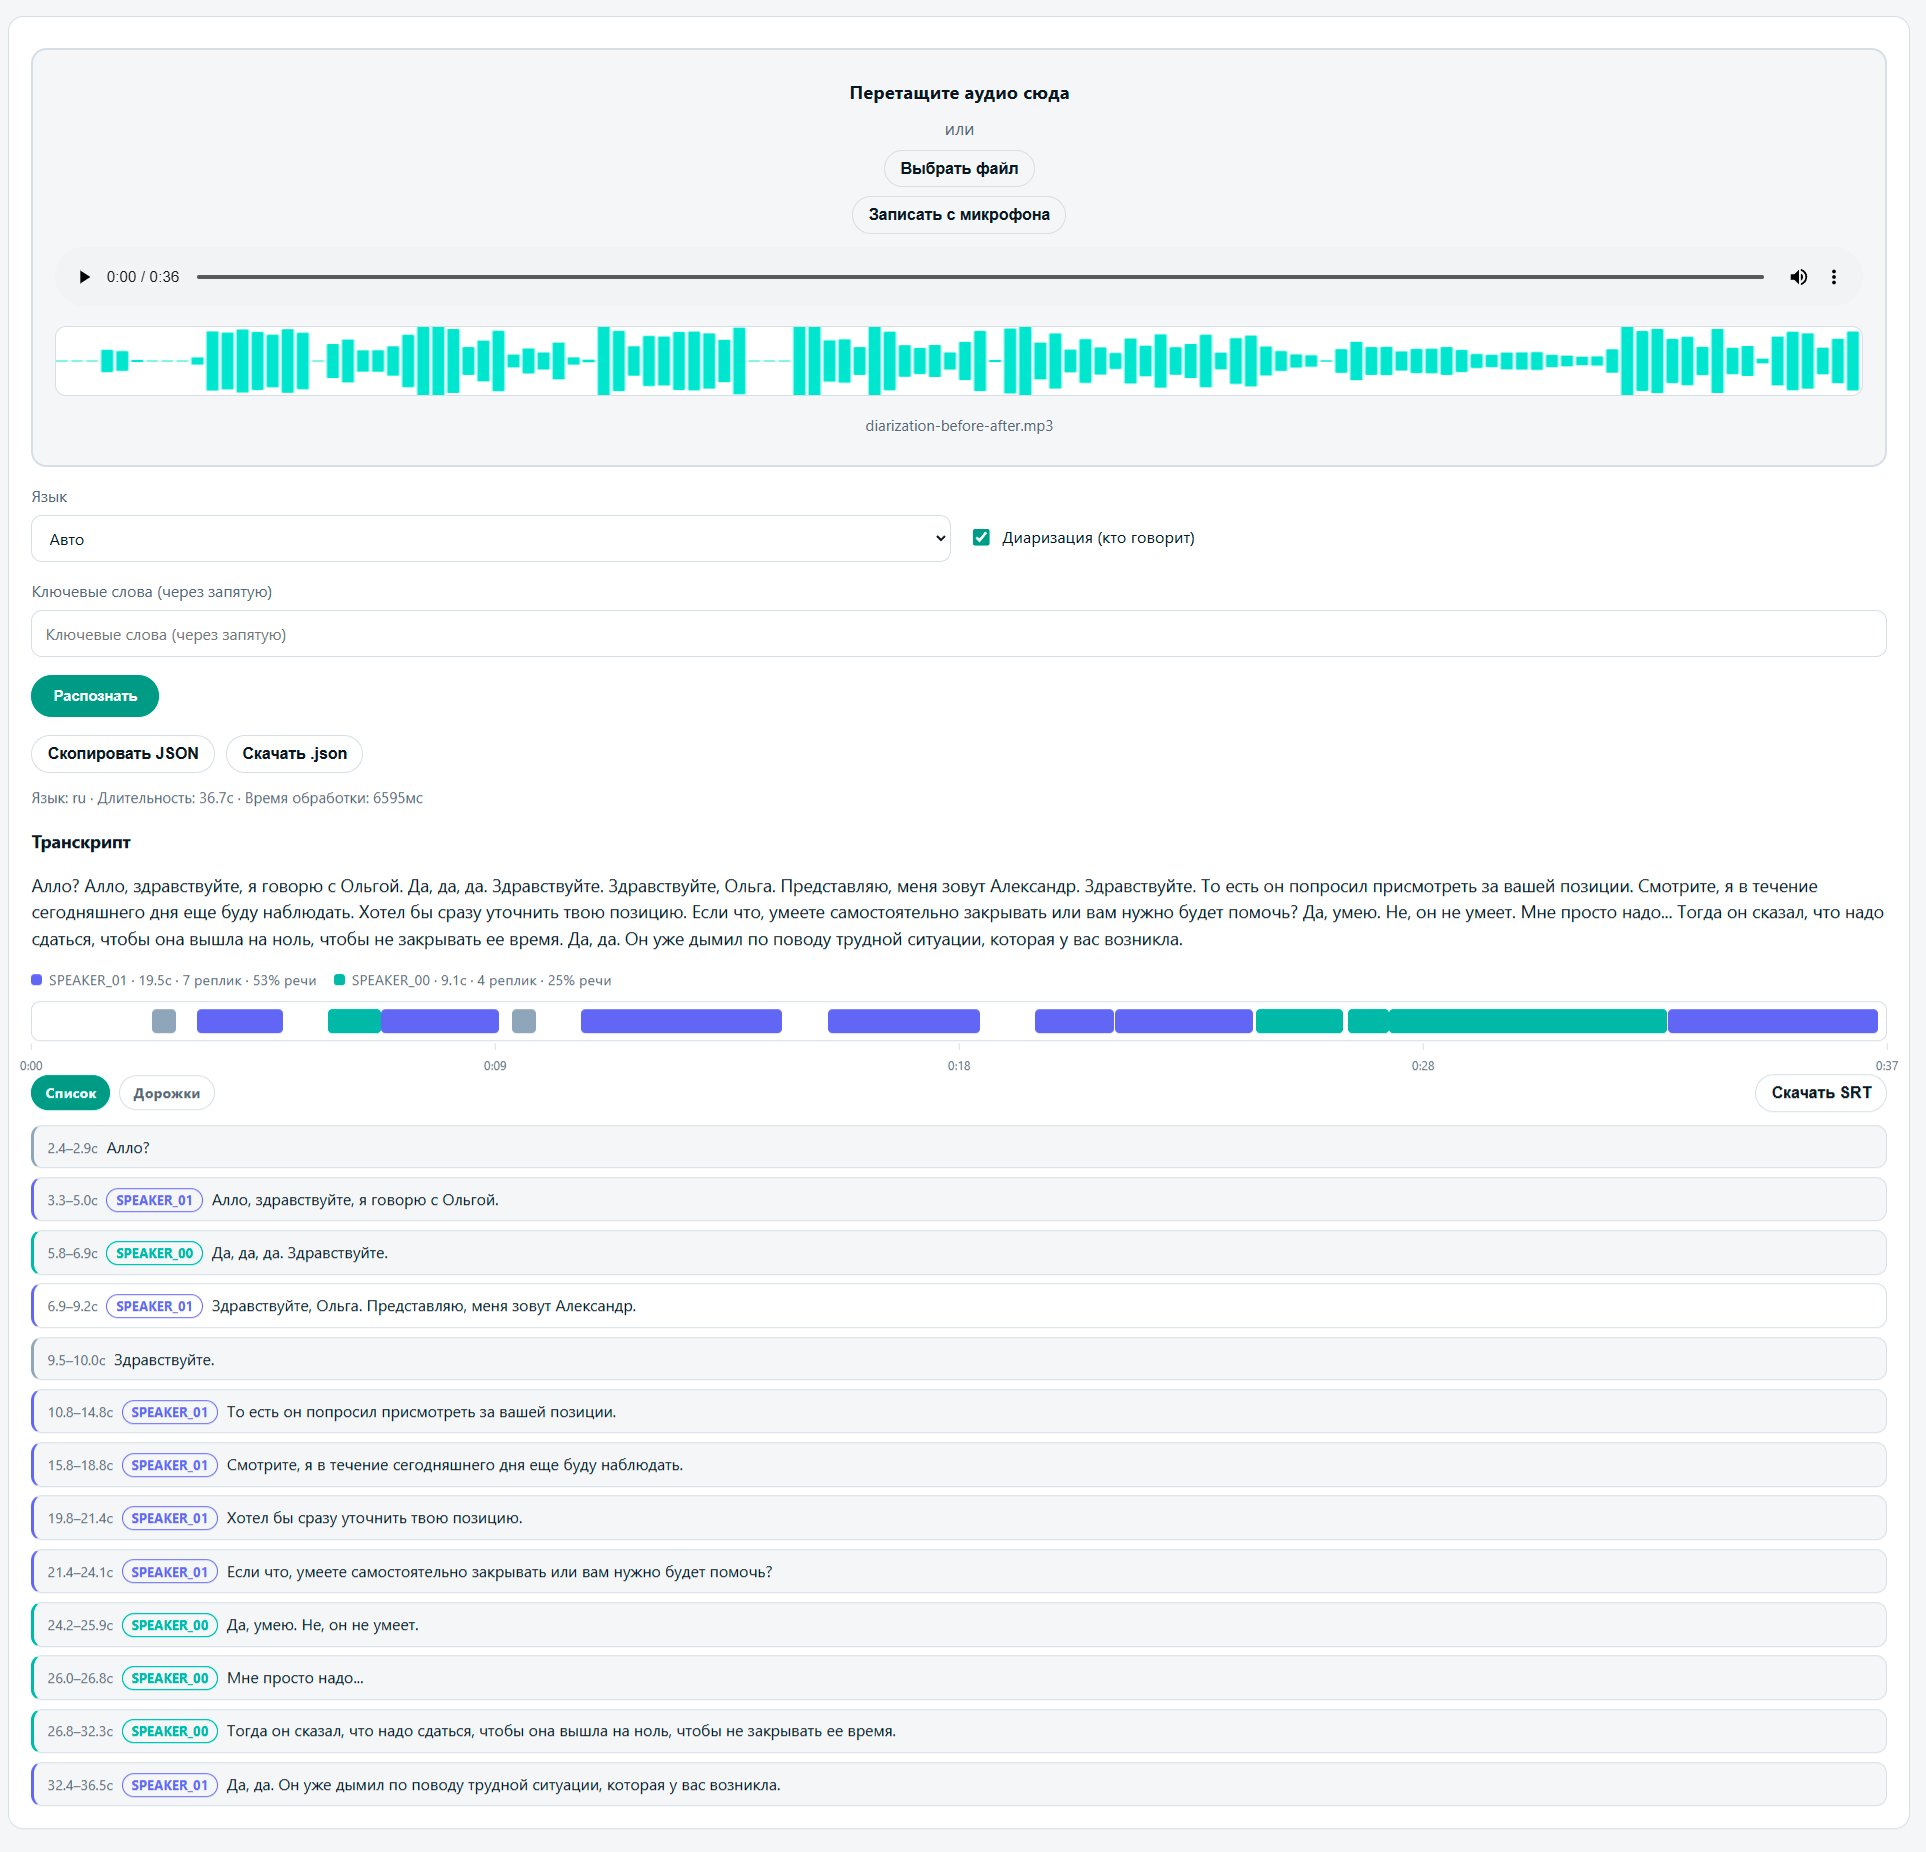
Диаризация (от английского diarize - «вести дневник», фиксировать, кто говорит) - это задача разметки аудио на реплики: кто и в какой момент говорил. На выходе вы получаете не просто текст, а последовательность сегментов с метками говорящих.
Формально задача распадается на два шага. Сегментация - найти границы речи: где одна реплика заканчивается и начинается другая, где пауза, а где сплошной монолог. Кластеризация - понять, что все эти кусочки принадлежат одному человеку, и присвоить им общую метку: Speaker 0, Speaker 1 и так далее.
Важно: диаризация не знает имён. Она не скажет «это Иван Петрович», а скажет «это спикер номер один, и он же говорил вот в этих пяти местах». Сопоставить Speaker 1 с конкретным человеком - отдельный шаг. И не путайте диаризацию с идентификацией голоса: диаризация отвечает, сколько говорящих и кто в какой момент, не зная заранее, кто эти люди. В 95% бизнес-задач достаточно именно её.
Как это работает под капотом
Современный подход устроен так. Система режет аудио на короткие отрезки и для каждого строит эмбеддинг - компактный числовой вектор, своего рода «отпечаток голоса». Два отрезка, произнесённые одним человеком, дают близкие эмбеддинги, отрезки разных людей - далёкие. Затем алгоритм кластеризации собирает похожие отпечатки в группы: каждая группа - один говорящий.
Ключевой нюанс - сколько говорящих искать. Системе можно подсказать точное число («в записи ровно два человека») или оставить его неизвестным. Второй вариант гибче, но чаще ошибается: при похожих голосах кластеризация может склеить двух людей в одного или, наоборот, размножить одного на двух. Поэтому в API обычно есть параметр, которым число спикеров фиксируется, если оно известно.
Ещё один слой - overlap, наложение речи. Когда два человека говорят одновременно, STT выдаёт кашу, и диаризация не всегда честно разделяет, кто что произнёс. Продвинутые системы помечают такие участки отдельно. На практике с наложением борются так: в звонке колл-центра речь оператора и клиента физически разделена по каналам, поэтому overlap почти не возникает.
Зачем это колл-центрам: главный сценарий
Если бы диаризация существовала ради одного применения, это был бы анализ звонков. Колл-центр генерирует сотни и тысячи записей в день, и слушать их руками невозможно. Обычно проверяют выборочно - 3–5% звонков на оператора. Диаризация в связке с STT меняет правила игры: все звонки превращаются в структурированный текст с атрибуцией реплик, и его можно анализировать автоматически.
Что это даёт на практике. Контроль качества и скриптов: система проверяет, представился ли оператор, предупредил ли о записи, корректно ли попрощался, - по всем звонкам, а не по выборке. Оценка регламента: кто именно нарушил - видно по меткам спикера. Обучение новичков: можно вытащить лучшие диалоги опытных операторов и разобрать их на тренинге. И разбор конфликтов: «клиент говорит, что его оскорбили» превращается из слова против слова в текст с атрибуцией.
Конкретный пример. Оператор должен был проговорить: «Компания Ромашка, меня зовут Анна, звонок записывается». STT выдаёт эту фразу как часть сплошного текста, и формально она есть. Но диаризация показывает, что половину фразы произнёс оператор, а половину - клиент, который перебил. Без атрибуции звонок засчитали бы как «скрипт соблюдён», хотя на деле оператор не представился.
Диаризация за пределами колл-центра
Интервью и журналистика. Расшифровка интервью с таймкодами - стандартная боль журналистов и исследователей. Диаризация сразу разбивает текст на «вопрос - ответ», и вы не путаете, где цитата собеседника, а где реплика интервьюера. Особенно ценно, когда в разговоре участвуют трое: ведущий и два гостя.
Подкасты и совещания. Транскрипт подкаста без разметки спикеров почти бесполезен для читателя; с диаризацией вы получаете готовый материал для статьи, тайм-коды для шоуноутов и поиск по эпизодам. Запись созвона на десять человек без разметки - хаос; диаризация раскладывает его по полочкам: кто предложил, кто возразил, кто взял задачу.
Медицина и юриспруденция. Врачебные консультации, допросы, заседания - здесь точность атрибуции реплик не удобство, а требование: нельзя, чтобы в протоколе реплика врача была приписана пациенту. Общее правило одно: диаризация делает расшифровку пригодной для дальнейшей обработки - поиска, аналитики, протоколов и отчётов.
Сложные случаи: где диаризация ошибается
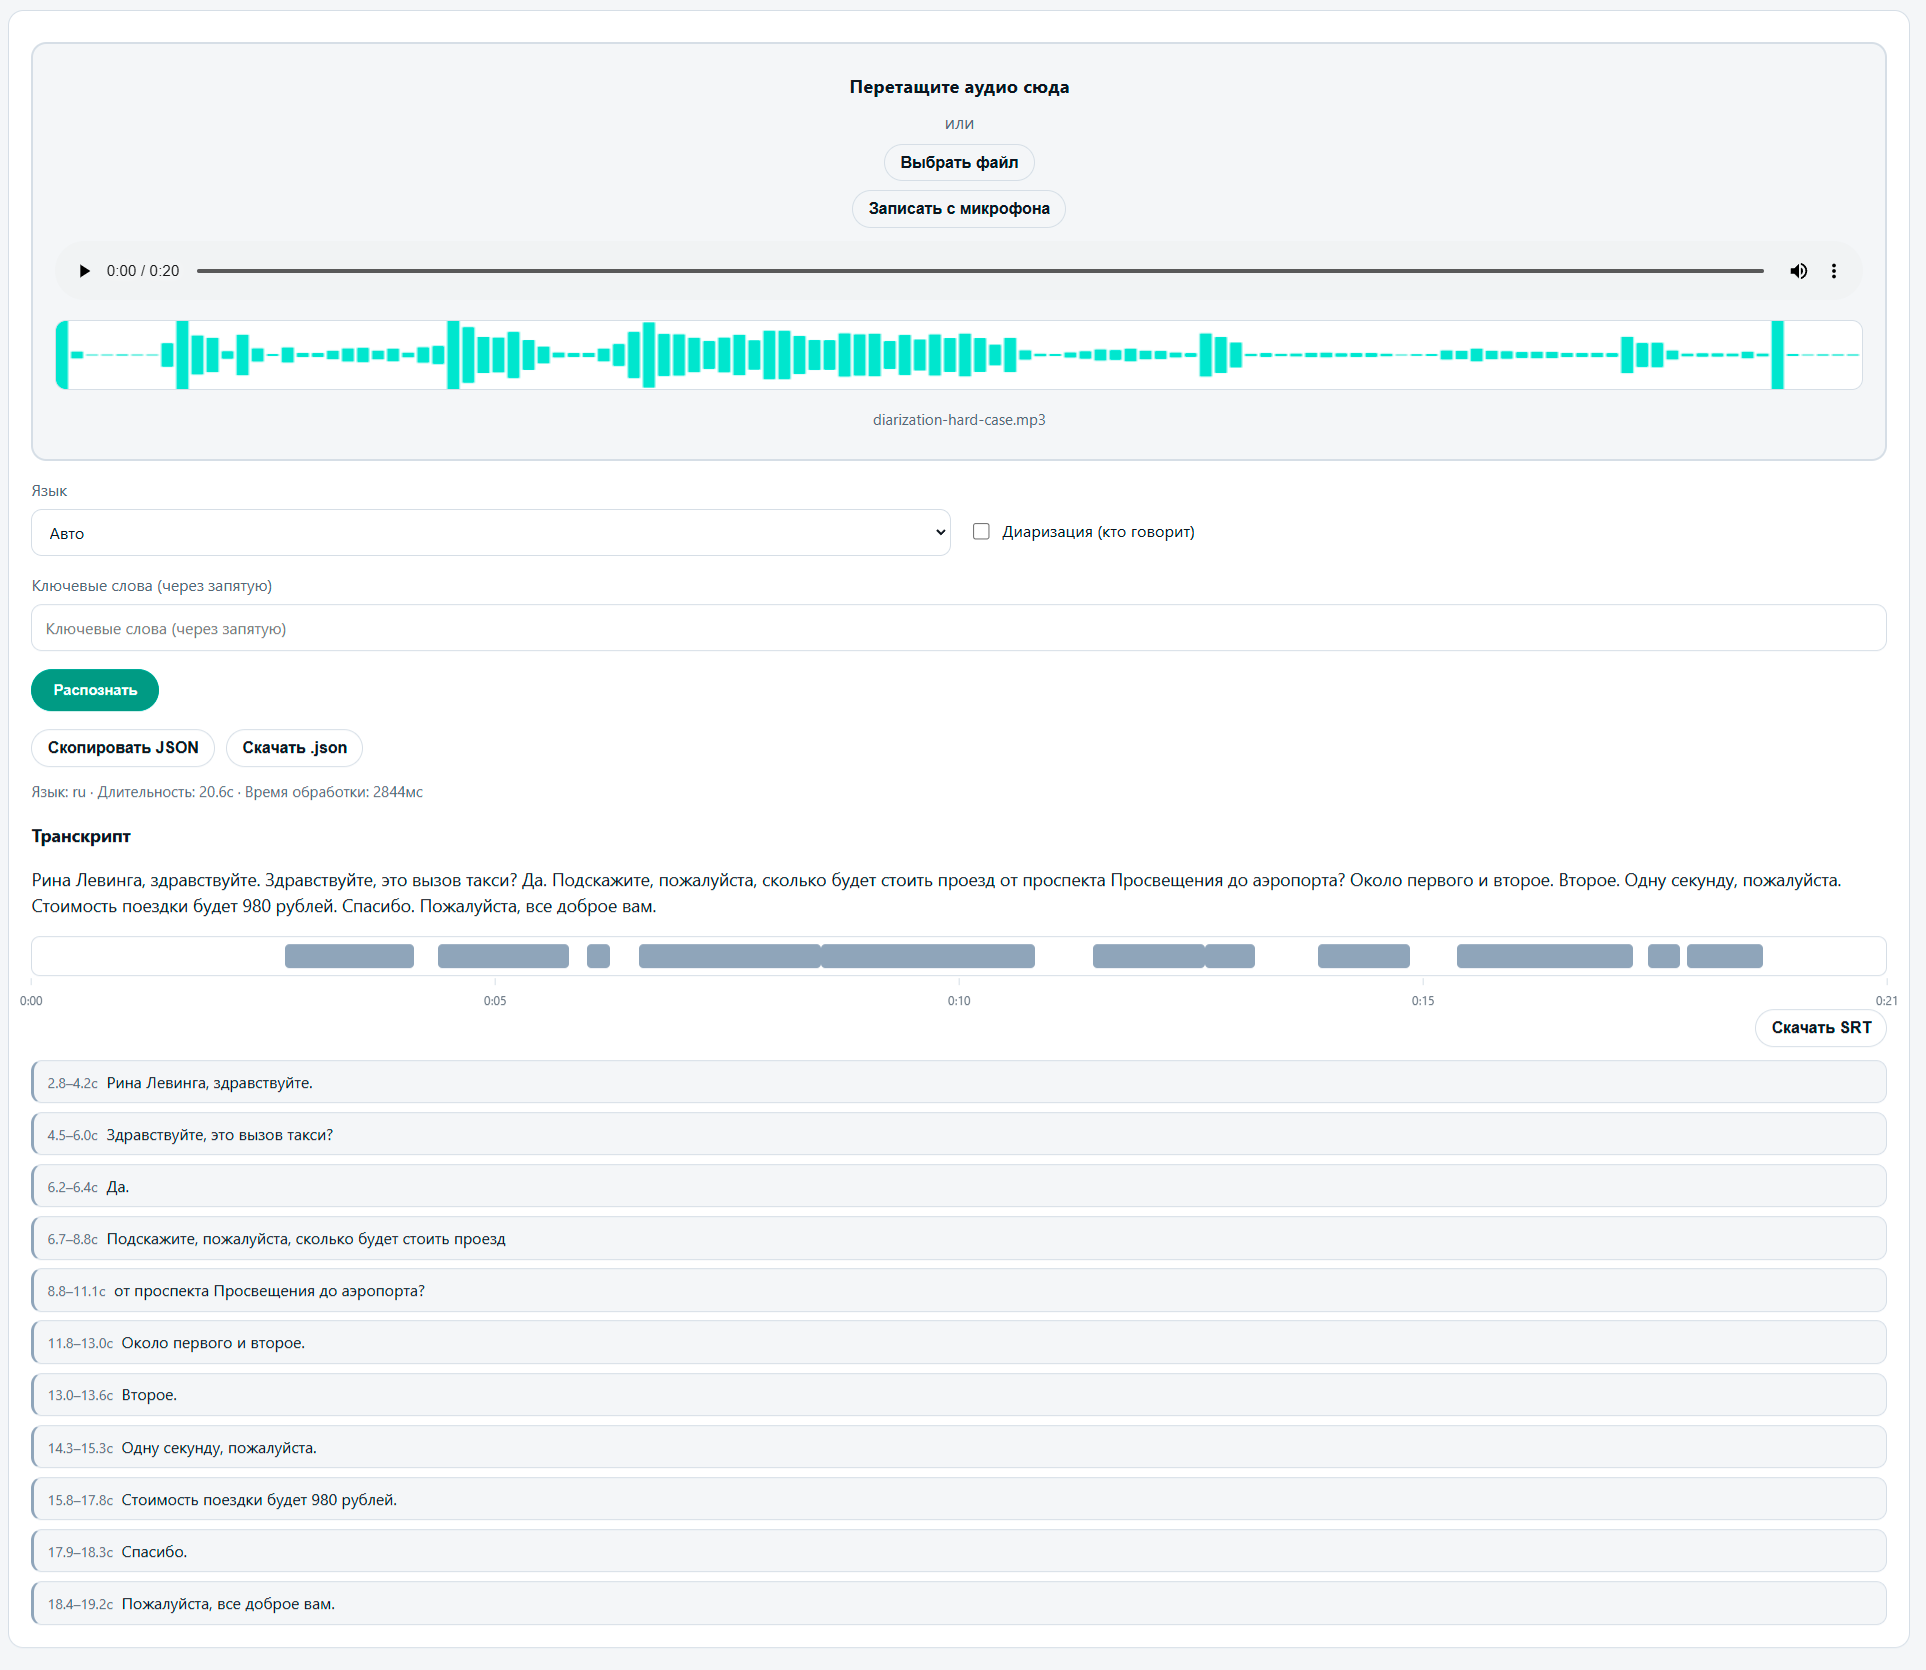
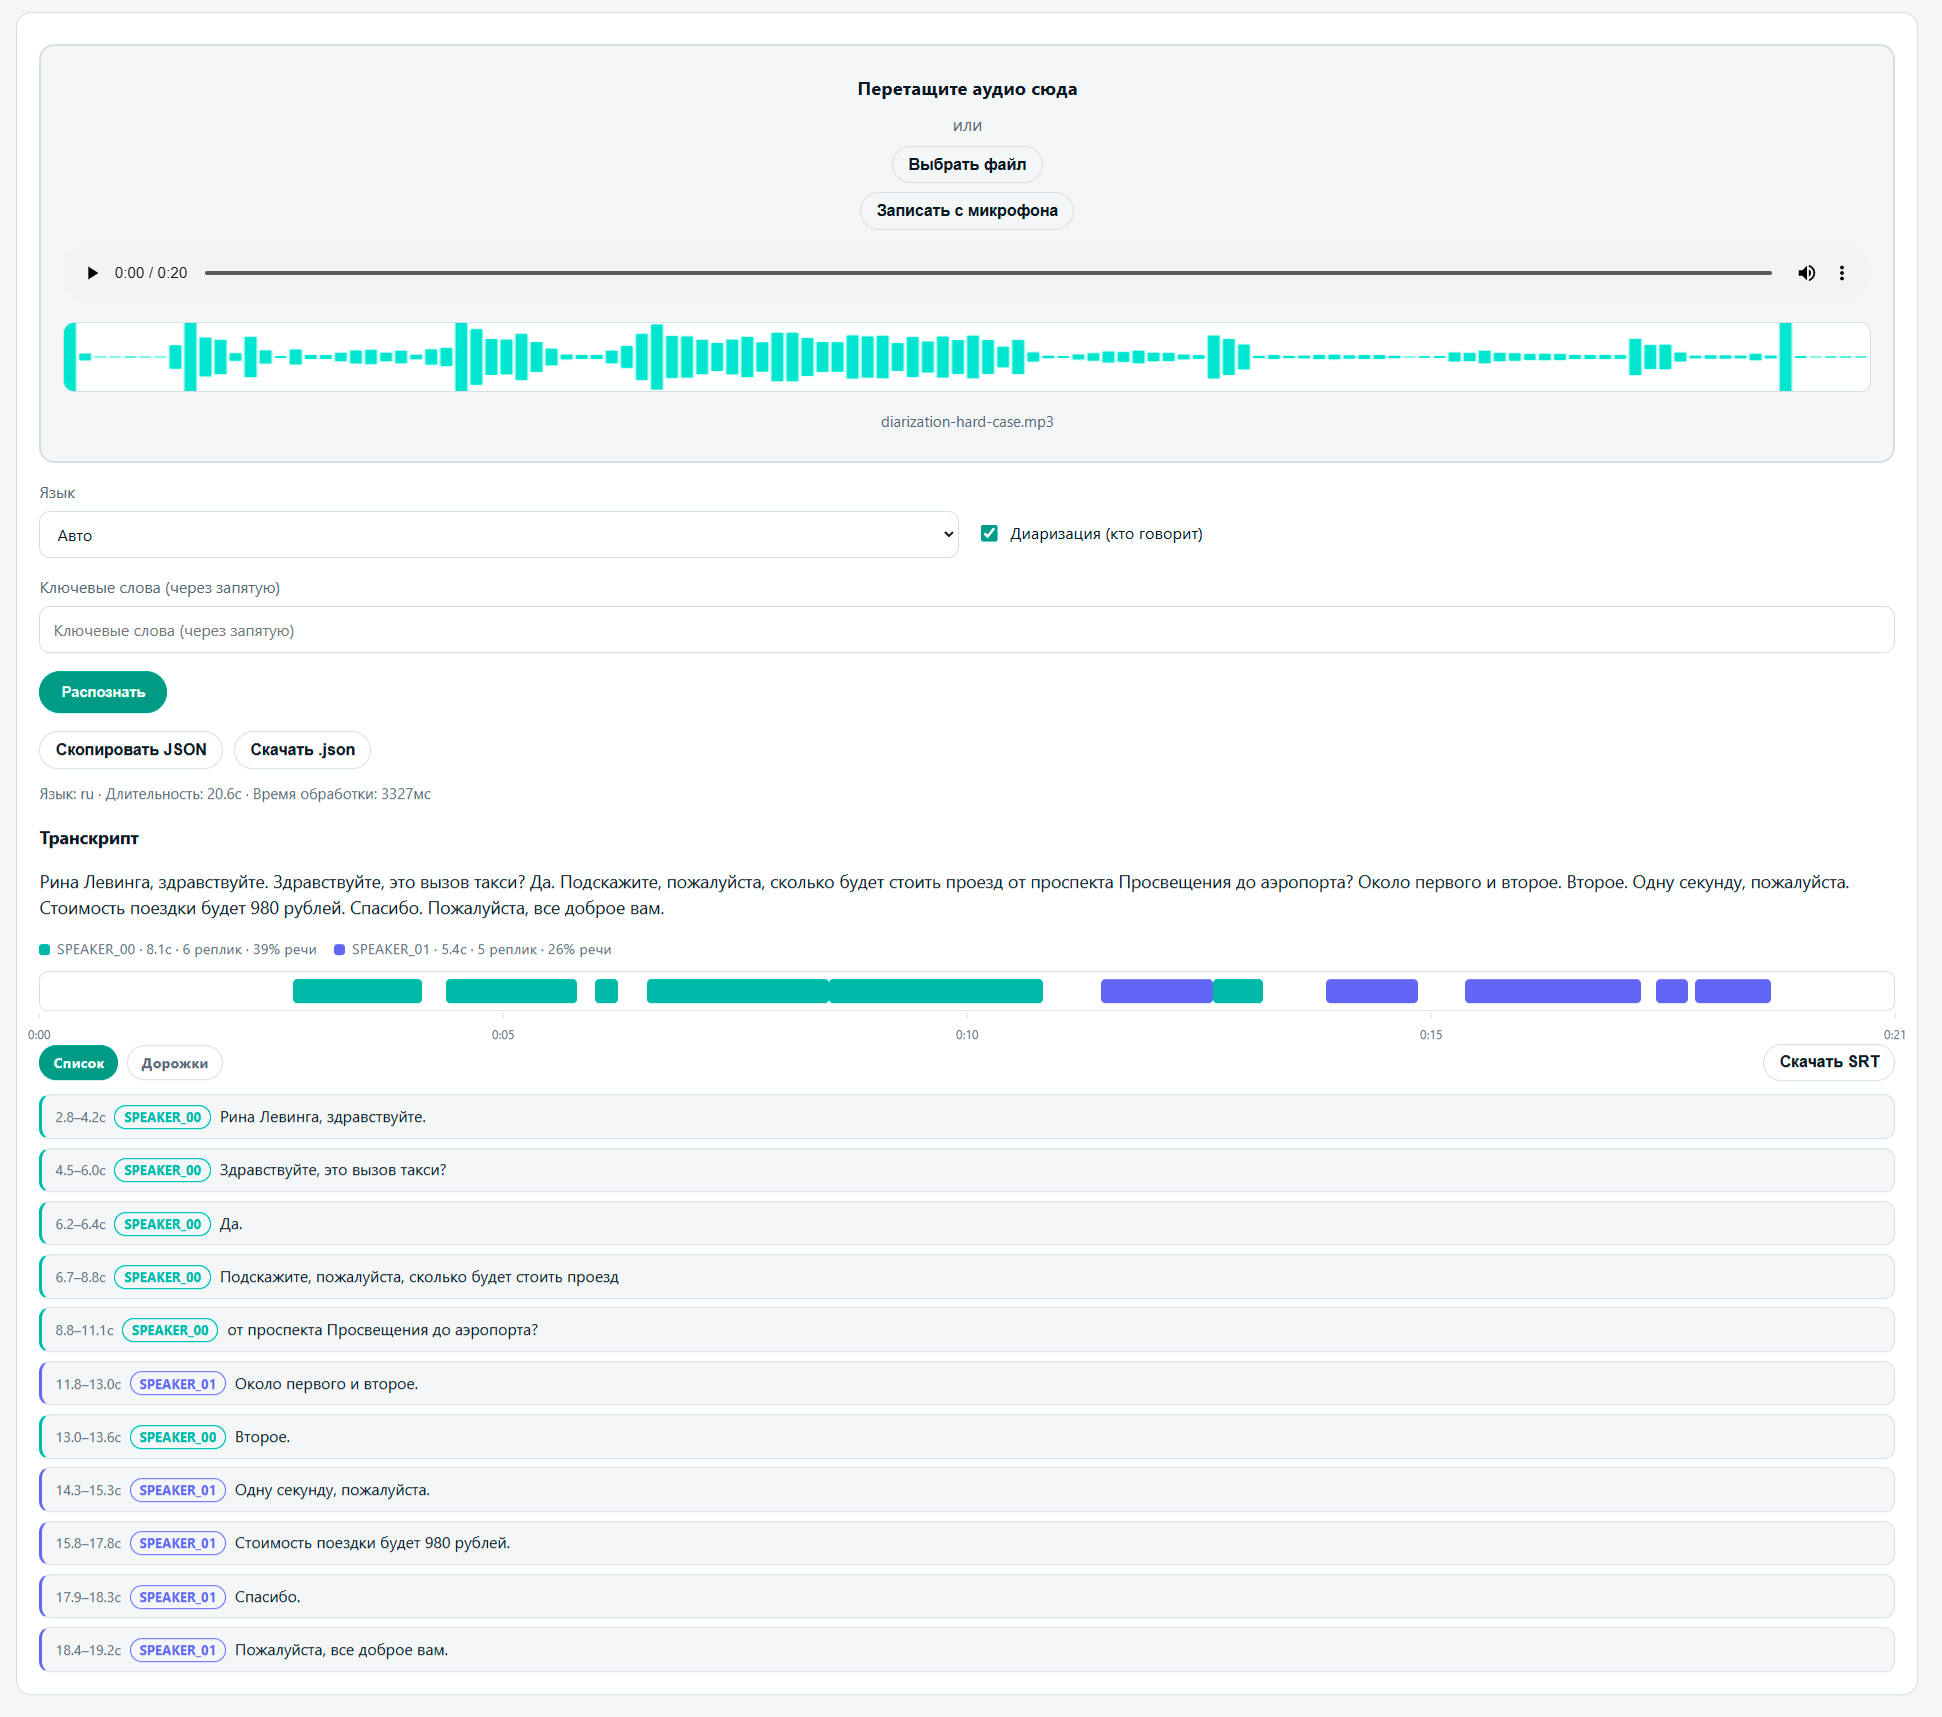
Было бы нечестно говорить о технологии и не сказать о её границах. Похожие голоса: два человека одного пола с близким тембром - классический стресс-тест, кластеризация может склеить их в одного. Обратная ошибка - один человек, который меняет интонацию, может быть разрезан на двух.
Наложение речи: когда говорят одновременно, и STT, и диаризация работают хуже. Неизвестное число говорящих: если не подсказать системе, что в записи ровно два человека, а их на деле пять, метки могут поплыть. И качество записи: шум, эхо, телефонный кодек «съедают» отпечаток голоса - мусор на входе даёт мусор на выходе.
Качество диаризации оценивают метрикой DER (diarization error rate) - долей времени аудио, размеченной неверно: пропущенная речь, ложная речь и речь, приписанная не тому говорящему. На чистых телефонных записях с двумя спикерами хорошие системы дают DER в единицы процентов, на шумных многоспикерных - заметно выше. Спрашивайте у сервиса и WER, и DER, и прогоняйте на своей записи.
Диаризация в API: как это выглядит
Хватит теории - посмотрим, как диаризация выглядит в коде. В Voice kit API она включается одним параметром в запросе на транскрибацию:
from voicekit import VoiceKitClient

client = VoiceKitClient(api_key="rtt_…")

result = client.transcribe(
    "call-2026-09-14.mp3",
    language="ru",
    diarization=True,
    speakers_count=2,
)

for segment in result.segments:
    print(f"[{segment.start:6.2f}–{segment.end:6.2f}] "
f"{segment.speaker}: {segment.text}")[ 0.00– 2.14] Speaker 0: Здравствуйте, компания Ромашка, меня зовут Анна.
[ 2.14– 2.40] Speaker 1: Да, добрый день. Подскажите, а мой заказ уже отправили?
[ 2.40– 5.80] Speaker 0: Сейчас посмотрю. Назовите, пожалуйста, номер заказа.
[ 5.80– 6.90] Speaker 1: Шестьсот сорок два.Параметр speakers_count не обязателен. Если его не передать, система попробует определить число говорящих сама. Но если вы знаете его заранее (а в звонке колл-центра это почти всегда два), подсказка почти всегда улучшает результат.
Таймкоды идут на уровне сегментов, а текст внутри сегмента можно получить и со слово-уровневой детализацией, чтобы подсвечивать отдельные сомнительные слова. Полную схему ответа и параметры - смотрите документацию.
Как улучшить качество диаризации: 5 практических советов
Диаризация - не чёрный ящик, на который нельзя влиять. Первое: подсказывайте число говорящих - если знаете, что в записи два человека, передавайте speakers_count=2. Второе: разделяйте каналы - в стереозаписи, где оператор слева, а клиент справа, диаризация получает идеальное разделение почти даром; даже простая нормализация громкости и шумоподавление помогают.
Третье: не режьте запись на куски - кластеризации нужно видеть всего говорящего, чтобы собрать его реплики в одну метку; разрезанный на минуты звонок может дать разные метки одного человека. Четвёртое: оценивайте на своих данных - прогоните 10–20 реальных звонков и посчитайте ошибки атрибуции; маркетинговые цифры DER ничего не скажут о вашей акустике.
Пятое: не ждите имён. Диаризация даёт Speaker 0 и Speaker 1, а не «Анна» и «клиент». Сопоставление меток с ролями - это правило в вашем коде: например, первый говорящий в звонке колл-центра обычно оператор.
Диаризация или просто STT: когда она реально нужна
Честный вопрос напоследок: а не переплачиваем ли мы за лишнюю технологию? Ответ зависит от того, что вы делаете с текстом дальше. Диаризация не нужна, если вы расшифровываете монолог - лекцию, аудиокнигу, односпикерный подкаст - или если нужен просто поиск по тексту без атрибуции. Здесь STT справляется сам.
Диаризация нужна, если в записи больше одного голоса и от того, кому принадлежит реплика, зависит смысл: анализ звонков, оценка работы операторов, интервью, совещания, протоколы, разбор конфликтов. Здесь текст без атрибуции - это текст, из которого вынули половину информации.
Хорошая новость: в современных API диаризация не отдельный сложный сервис, а флаг в том же запросе на транскрибацию. Включил - получил разметку, не включил - обычный текст. Поэтому выбирать «либо STT, либо диаризацию» не приходится: вы включаете её ровно там, где она окупается.
Итоги
Диаризация отвечает на вопрос, который speech-to-text принципиально не задаёт: кто говорит. Она разбивает аудио на реплики и присваивает каждой метку говорящего - Speaker 0, Speaker 1 и так далее. Без имён, но с точной атрибуцией: этого достаточно, чтобы превратить слитную расшифровку в структурированный диалог, который можно анализировать, искать и превращать в протоколы.
Технология не идеальна: похожие голоса, наложение речи и шум - её слабые места. Но на типовых звонках колл-центра с двумя говорящими и разделёнными каналами она работает уверенно, а метрикой качества служит DER - доля времени, размеченного неверно.
Главное, что стоит запомнить: диаризация - это не фича для галочки, а способ извлечь из разговора его структуру. А структура - это то, ради чего вообще затевают расшифровку звонков. Загрузите свой звонок в демо и посмотрите, как запись раскладывается на реплики с метками спикеров.
Протестируйте диаризацию
Загрузите свой звонок в демо и посмотрите, как запись раскладывается на реплики с метками спикеров. Бесплатного лимита хватит, чтобы оценить качество на ваших данных.
Загрузить свою запись смотрите тарифы